Перший власний чип OpenAI перевершує NVIDIA за швидкістю та енергоефективністю
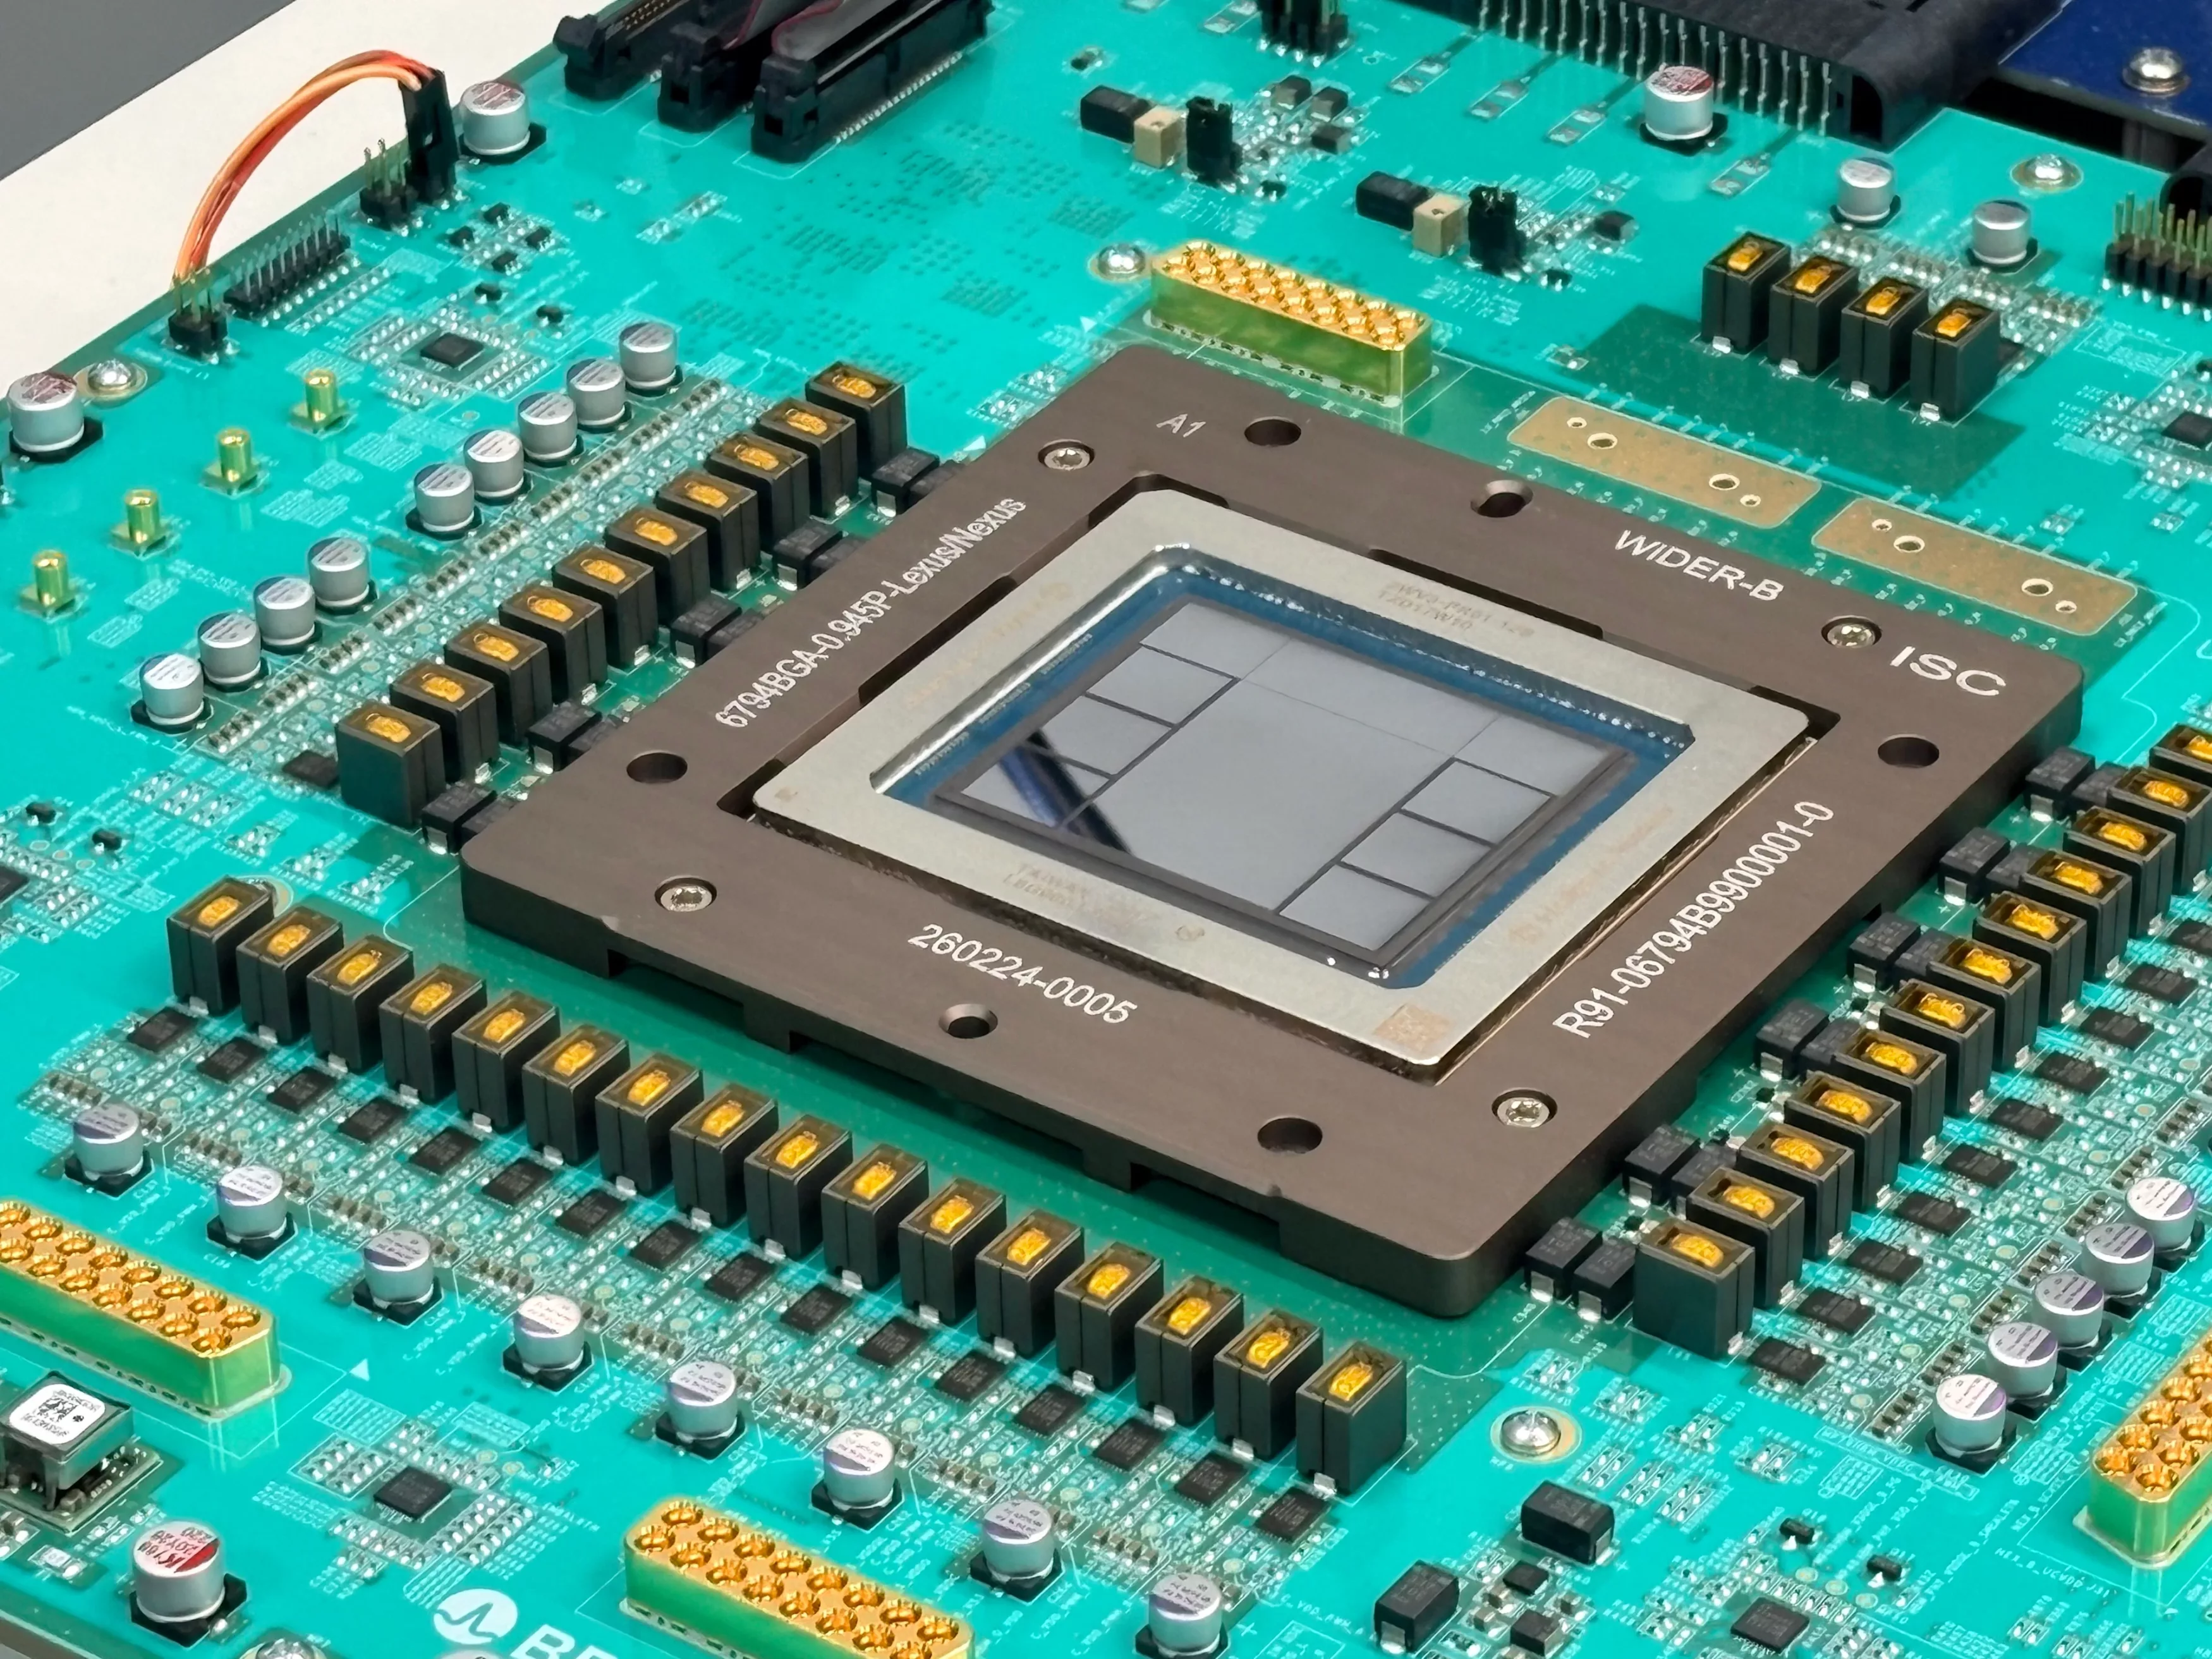
OpenAI опублікувала перші докладні показники продуктивності Jalapeño — свого першого чипа, розробленого спеціально для ШІ-інференсу. У власних тестах компанії на трьох великих мовних моделях чип забезпечив у 1,5–1,9 раза вищу пікову пропускну здатність на одиницю потужності та у 1,7–3,6 раза нижчу наскрізну затримку запитів, ніж системи NVIDIA GB200 і GB300, використані для порівняння. Це не означає, що NVIDIA втратила лідерство, однак демонструє, чому найбільші ШІ-компанії дедалі частіше прагнуть розробляти більше власного обладнання.
Jalapeño не конкурує з чипами для навчання
Це перший власний чип OpenAI для інференсу, тобто його оптимізовано насамперед для запуску вже навчених моделей, а не для навчання нових великих моделей з нуля. Компанія й надалі використовуватиме прискорювачі NVIDIA та інших партнерів як для навчання, так і для інференсу.
OpenAI використала публічний бенчмарк InferenceX і протестувала три моделі: GPT-OSS 120B, DeepSeek R1 670B і Kimi K2.5 1T. Для порівняння використовувалися NVIDIA GB200 і GB300.
З GPT-OSS 120B Jalapeño досяг пікової пропускної здатності 85 448 вхідних і вихідних токенів за секунду на кіловат, порівняно з 44 960 у GB200. Це дає Jalapeño перевагу приблизно у 1,9 раза. Наскрізна затримка запиту становила 1,03 секунди проти 1,80 секунди відповідно.
DeepSeek R1 продемонстрував ще більший розрив у затримці. Jalapeño виконав запит за 1,65 секунди, тоді як GB300 потребував 5,99 секунди. Пікова пропускна здатність на одиницю потужності сягнула 19 641 вхідного та вихідного токена за секунду на кіловат у Jalapeño та 11 781 у GB300. З Kimi K2.5 OpenAI виміряла приблизно у 1,5 раза вищу пікову пропускну здатність на одиницю потужності та у 3,4 раза нижчу загальну затримку для Jalapeño.
Це власні вимірювання OpenAI, а не результати незалежної лабораторії. Показники енергоефективності також слід розглядати в контексті методології. OpenAI нормалізувала результати за опублікованою номінальною потужністю прискорювачів, а не вимірювала фактичне енергоспоживання кожної конкуруючої системи за однакових умов.
Чип на 700 W споживав у тестах не більш як 550 W
Jalapeño має номінальну потужність 700 W. За даними OpenAI, фактичне енергоспоживання в протестованих робочих навантаженнях залишалося на рівні 550 W або нижче. Для своїх розрахунків компанія використала опубліковану NVIDIA номінальну потужність 1 200 W для GB200 і 1 400 W для GB300.
Обсяг роботи, виконаної на одиницю потужності, стає дедалі важливішим у великих ШІ-центрах обробки даних. Електрична потужність, охолодження та підключення до електромережі можуть так само обмежувати зростання серверних ферм, як і доступність чипів. Якщо з кожного кіловата можна обслуговувати більше запитів, інфраструктурні витрати на один згенерований токен або запит користувача знижуються.
Архітектура Jalapeño розроблена з урахуванням різних етапів інференсу мовних моделей. Початкова обробка вхідних даних, або prefill, є переважно обчислювально інтенсивною. Генерування відповіді токен за токеном, або decode, сильніше залежить від пропускної здатності пам’яті. Час також витрачається на переміщення даних і стану моделі між чипами та обчислювальними блоками.
OpenAI розробила процесор, пам’ять, мережеве з’єднання та програмне забезпечення як єдину інтегровану систему, щоб скоротити непотрібне переміщення даних. Зокрема, архітектура дає змогу KV-кешу, що використовується під час генерування відповіді, залишатися якомога локальнішим.
ШІ допоміг розробити сам чип
ШІ відіграв безпосередню роль у розробці Jalapeño. За даними OpenAI, команда пройшла шлях від початкового проєктування до tape-out за дев’ять місяців. ШІ використовували для дослідження варіантів реалізації, оптимізації арифметичних блоків і прискорення циклів верифікації та вимірювань.
Згодом команда використала Codex разом із GPT-Astra для оптимізації чипа під три моделі з відкритими вагами, які не були частиною початкового виробничого плану. Робота тривала два місяці. У вибраних блоках уваги та mixture-of-experts GPT-OSS реалізації, згенеровані ШІ, працювали у 1,5–1,8 раза швидше за попередні версії, написані експертами.
Є важливе застереження: цей приріст продуктивності стосується вибраних обчислювальних блоків, а не моделі GPT-OSS загалом.
Проблема NVIDIA поки не в Jalapeño, а в тенденції, що стоїть за ним
Один спеціалізований чип не змінить ринок ШІ-обладнання за одну ніч. Перевага NVIDIA полягає не лише в чистій обчислювальній продуктивності GB200 або GB300, а й у програмній екосистемі CUDA, мережевих рішеннях, серверній архітектурі та можливості використовувати одну платформу для широкого спектра моделей і робочих навантажень.
Значення Jalapeño полягає в іншому. OpenAI точно знає, які робочі навантаження створюють її власні сервіси, і може оптимізувати обладнання під них. Google, Amazon та інші великі хмарні компанії роками дотримуються тієї самої логіки. Вихід OpenAI на ринок із власним чипом посилює тиск у напрямі здешевлення та підвищення енергоефективності ШІ-обчислень.
OpenAI планує розгорнути Jalapeño у власній обчислювальній інфраструктурі до кінця 2026 року. Чип другого покоління вже перебуває на просунутій стадії розробки, тоді як архітектура третього покоління набуває обрисів.
Енергоефективність особливо важлива для Європи. Зростання ШІ-центрів обробки даних означає пряму конкуренцію за електричну потужність і підключення до електромережі. Якщо спеціалізовані чипи для інференсу справді можуть забезпечувати суттєво більше корисної роботи на кіловат, їхній економічний вплив може виявитися важливішим за будь-яку окрему перемогу над NVIDIA в бенчмарку.


